17.10.2026
Мульти-омикс и искусственный интеллект в ферментации молочных продуктов: от эмпирики к точной биотехнологии
Как омикс-технологии и объяснимый ИИ превращают ферментацию молока в управляемый и предсказуемый процесс
Ферментация молочных продуктов − это сложный биохимический процесс, в котором молочнокислые бактерии превращают лактозу, белки и липиды молока в молочную кислоту, ароматические соединения, биоактивные пептиды, экзополисахариды и другие метаболиты. Именно эти превращения определяют вкус, текстуру, срок хранения, безопасность и функциональные свойства конечного продукта. Традиционные методы контроля, основанные на pH, температуре и времени, дают лишь косвенную информацию и не позволяют увидеть процесс на молекулярном уровне.
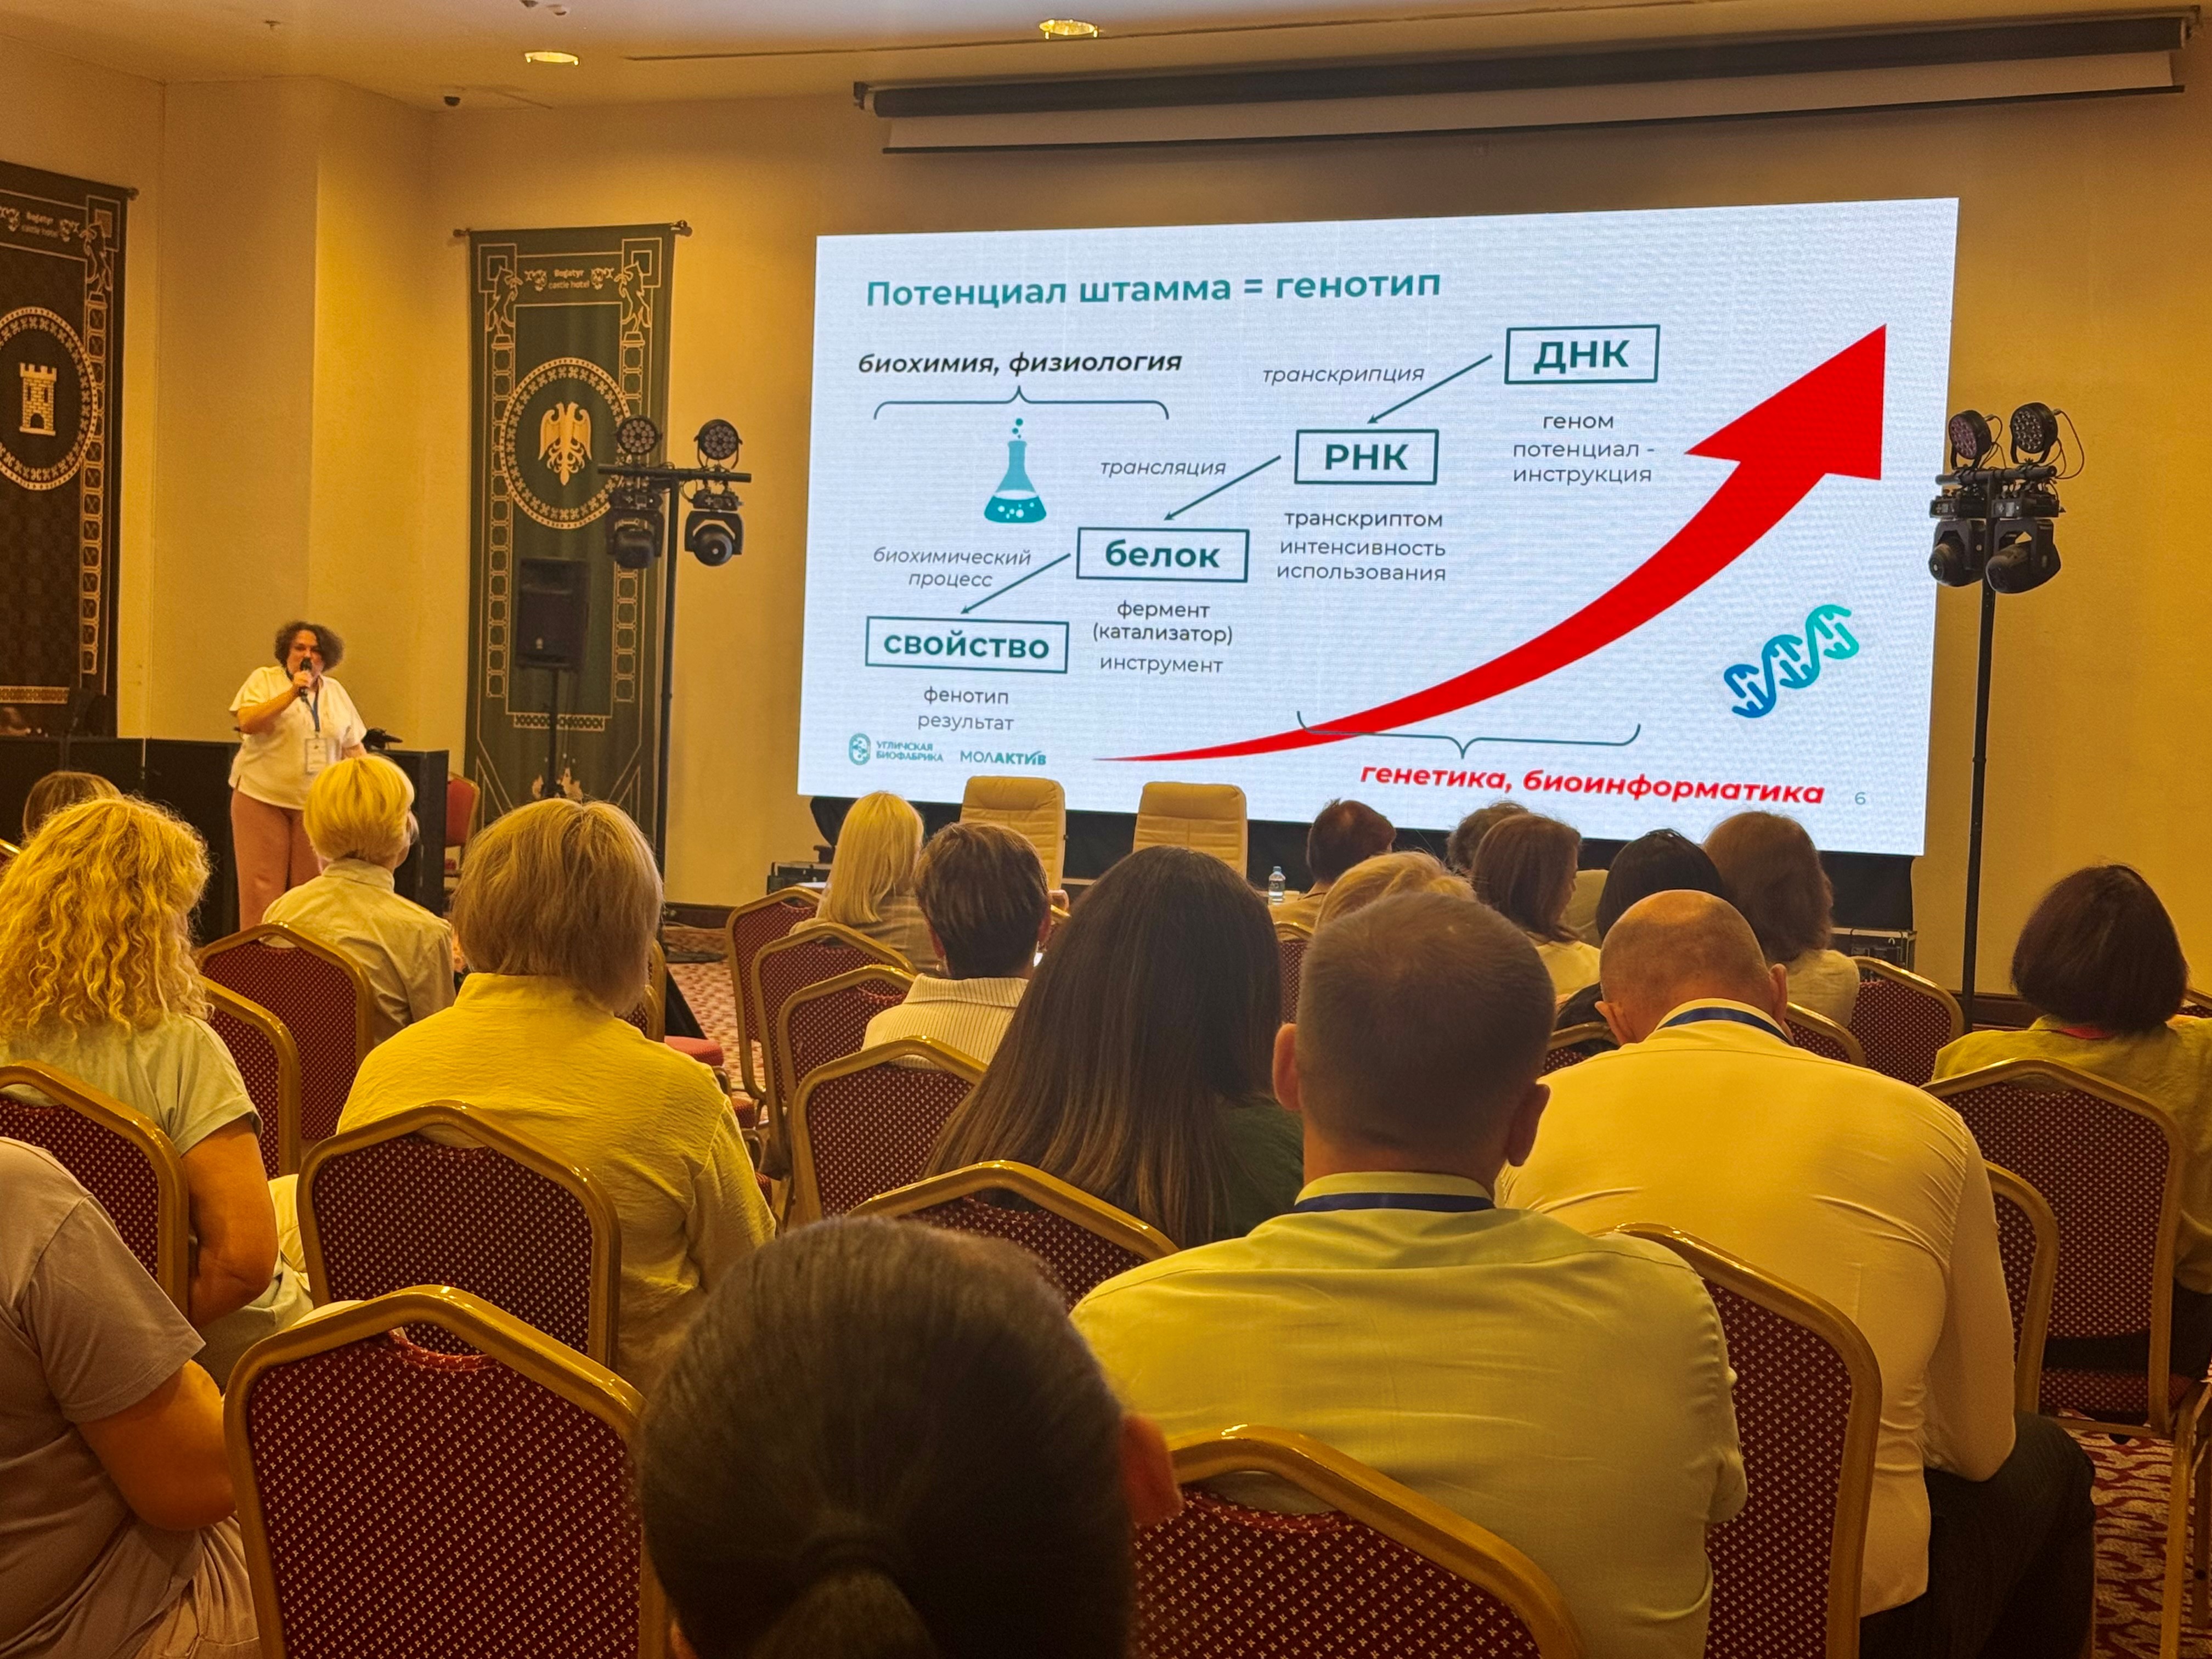
На этом фоне всё большее значение приобретают омикс-технологии − метаболомика, метагеномика, протеомика, транскриптомика и липидомика. Они позволяют одновременно отслеживать тысячи генов, белков, метаболитов и липидов, участвующих в ферментации. Каждая технология имеет свои сильные стороны: метаболомика отражает фенотип и помогает выявлять биомаркеры, геномика раскрывает генетический потенциал штаммов, протеомика показывает функциональную активность белков, транскриптомика − какие гены активны в конкретных условиях, а липидомика характеризует жировой профиль продукта. Однако по отдельности ни одна из них не способна описать всю сложность ферментации.
Поэтому необходим мульти-омикс подход − интеграция данных разных уровней. Для объединения разнородных данных разработаны специальные стратегии: ранняя, промежуточная и поздняя интеграция. Наиболее известные методы − DIABLO, SNF, MOFA, RGCCA, MCIA − позволяют выявлять общие закономерности, биомаркеры и взаимосвязи между микробным составом, метаболитами и качеством продукта. При этом омикс-данные крайне чувствительны к условиям сбора, подготовки и анализа образцов: batch-эффекты, малые выборки, шум и разная размерность данных могут искажать результаты. Поэтому стандартизация протоколов, сбор метаданных и соблюдение принципов FAIR имеют критическое значение.
Дополнительную сложность создаёт высокая размерность данных, из-за которой традиционная статистика часто оказывается бессильной. Здесь на помощь приходит искусственный интеллект, включая машинное и глубокое обучение. Модели на основе ИИ применяются для прогнозирования кинетики ферментации, подкисления, роста микроорганизмов, накопления ароматических соединений, оценки качества и даже для выявления терапевтического потенциала продуктов. Наиболее часто используются Random Forest, SVM, XGBoost, искусственные нейронные сети, LSTM и гибридные архитектуры. Выбор алгоритма зависит от объёма и типа данных, а не от универсального превосходства одного метода.
Однако высокая прогнозная точность ИИ не равна биологической интерпретируемости: сложные модели часто работают как «чёрный ящик». Для решения этой проблемы развиваются подходы объяснимого искусственного интеллекта (XAI), такие как SHAP, LIME и механизмы внимания. Они показывают, какие именно переменные − гены, метаболиты, белки или технологические параметры − вносят наибольший вклад в прогноз. Это особенно важно для промышленного применения, где оператор должен понимать, почему модель рекомендует то или иное вмешательство.
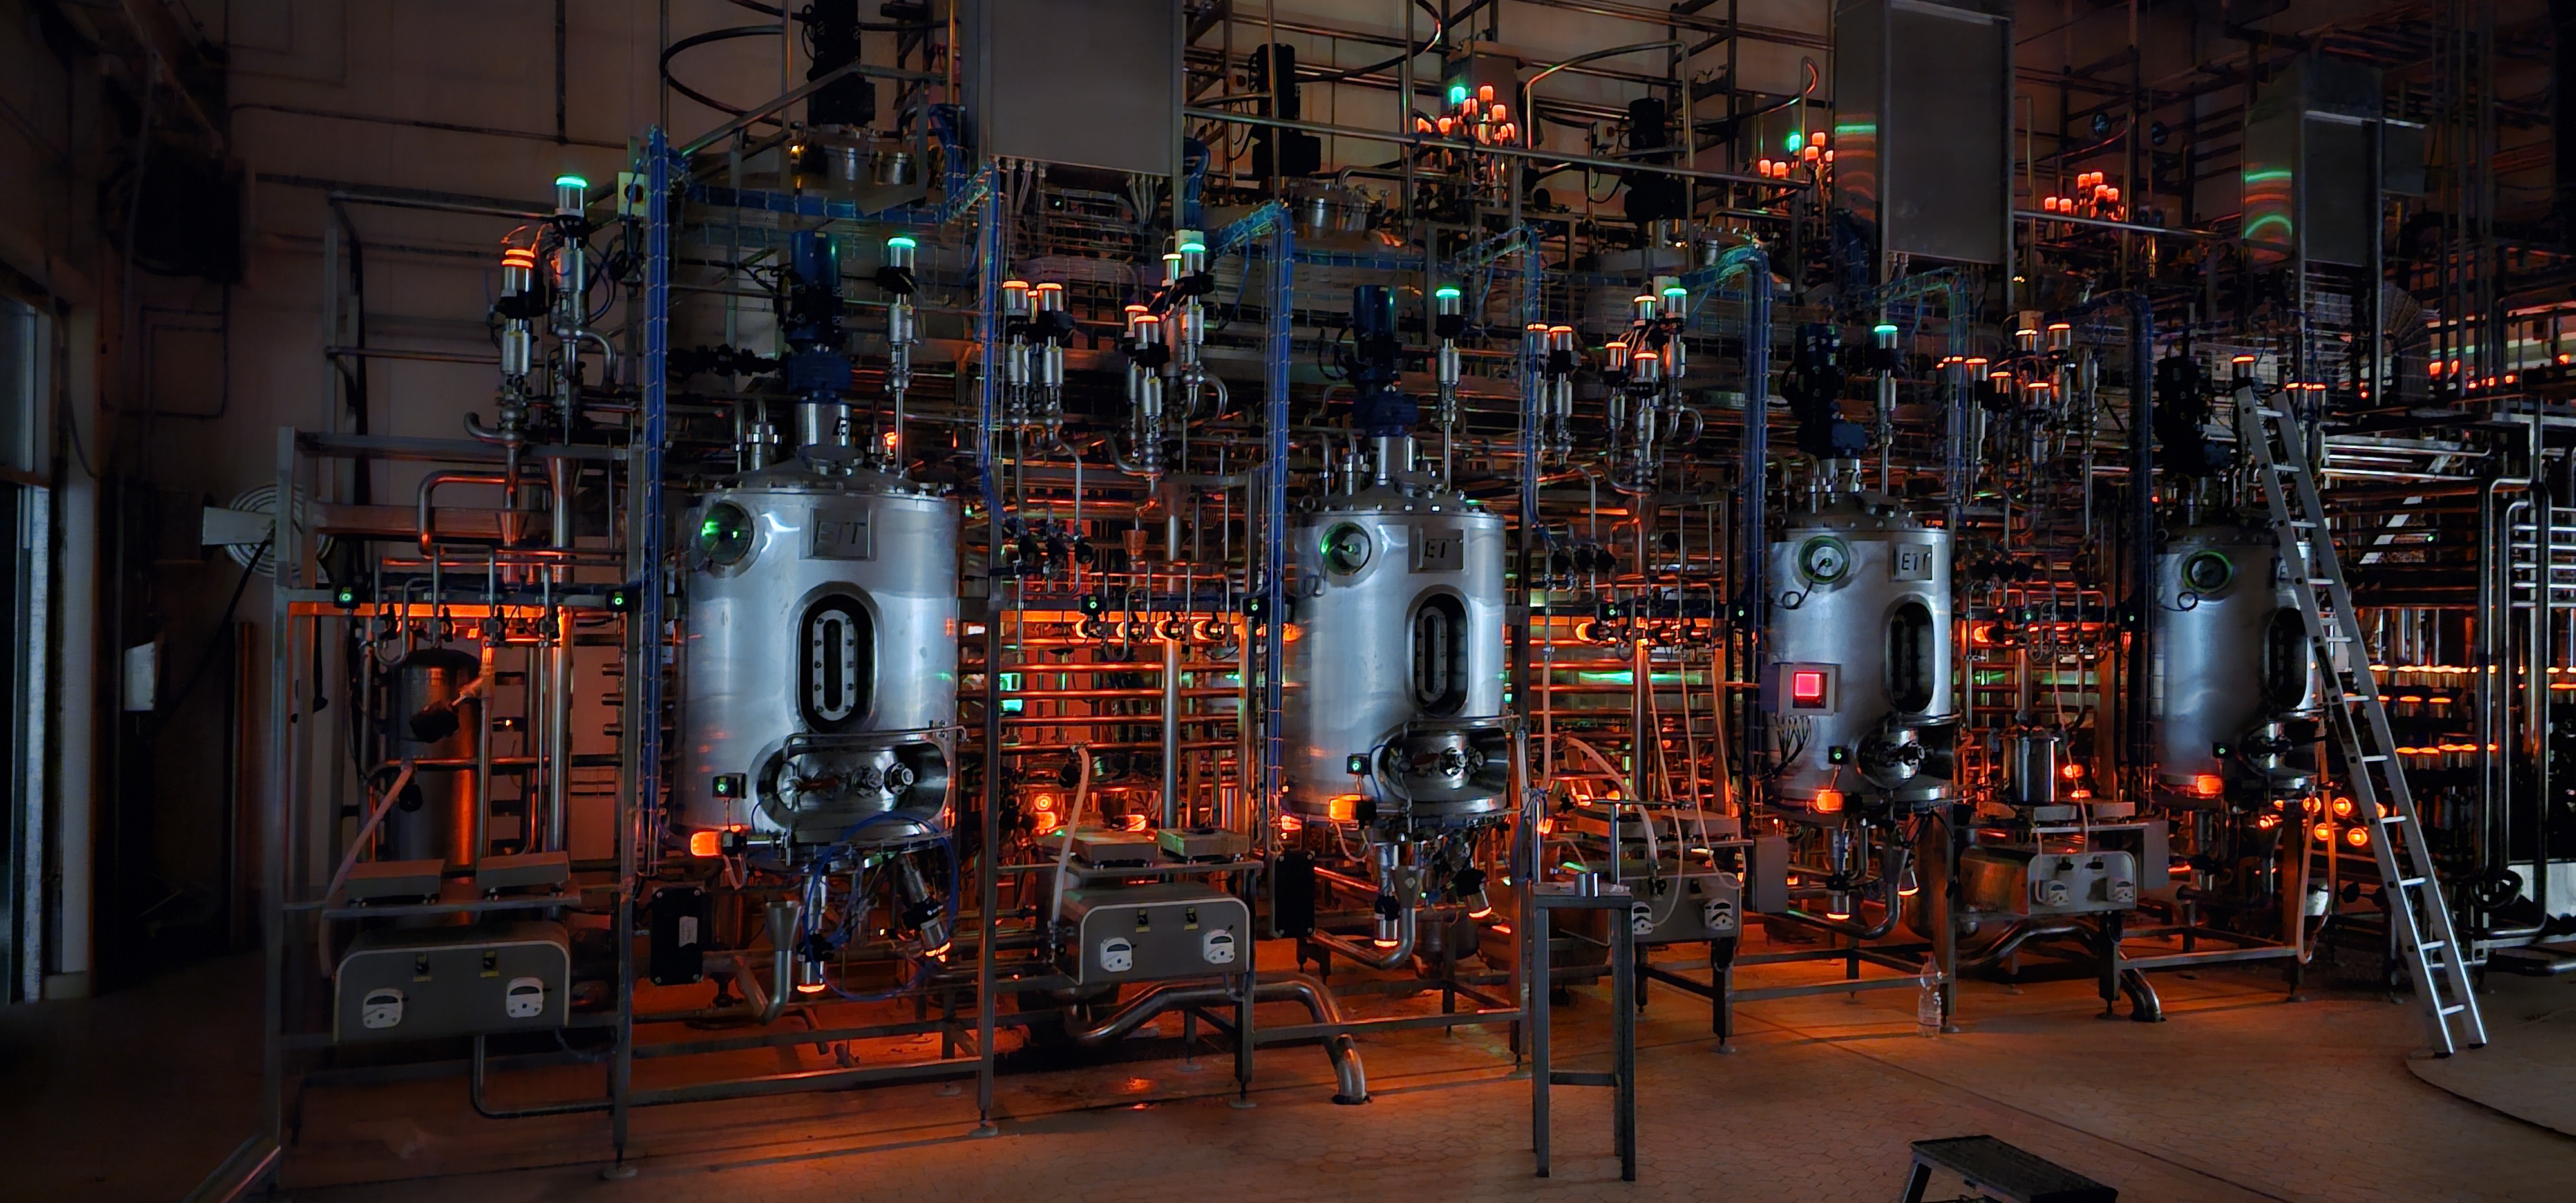
Дополнительным инструментом становится цифровой двойник − виртуальная копия ферментационного процесса, которая обновляется в реальном времени и позволяет тестировать сценарии без риска для производства. В сочетании с IoT и ИИ он обеспечивает мониторинг, оптимизацию и раннее обнаружение отклонений.
Несмотря на значительный прогресс, большинство исследований пока остаются лабораторными. Перенос мульти-омикс и ИИ-подходов в реальное промышленное производство затруднён из-за высокой стоимости, вычислительных требований, нехватки стандартизированных рабочих процессов и ограниченной валидации на крупных масштабах. Тем не менее именно интеграция мульти-омикс данных, объяснимого ИИ и цифровых двойников рассматривается как путь к переходу молочной ферментации от эмпирического искусства к предсказуемой, управляемой и точной биотехнологической платформе.
На этом фоне всё большее значение приобретают омикс-технологии − метаболомика, метагеномика, протеомика, транскриптомика и липидомика. Они позволяют одновременно отслеживать тысячи генов, белков, метаболитов и липидов, участвующих в ферментации. Каждая технология имеет свои сильные стороны: метаболомика отражает фенотип и помогает выявлять биомаркеры, геномика раскрывает генетический потенциал штаммов, протеомика показывает функциональную активность белков, транскриптомика − какие гены активны в конкретных условиях, а липидомика характеризует жировой профиль продукта. Однако по отдельности ни одна из них не способна описать всю сложность ферментации.
Поэтому необходим мульти-омикс подход − интеграция данных разных уровней. Для объединения разнородных данных разработаны специальные стратегии: ранняя, промежуточная и поздняя интеграция. Наиболее известные методы − DIABLO, SNF, MOFA, RGCCA, MCIA − позволяют выявлять общие закономерности, биомаркеры и взаимосвязи между микробным составом, метаболитами и качеством продукта. При этом омикс-данные крайне чувствительны к условиям сбора, подготовки и анализа образцов: batch-эффекты, малые выборки, шум и разная размерность данных могут искажать результаты. Поэтому стандартизация протоколов, сбор метаданных и соблюдение принципов FAIR имеют критическое значение.
Дополнительную сложность создаёт высокая размерность данных, из-за которой традиционная статистика часто оказывается бессильной. Здесь на помощь приходит искусственный интеллект, включая машинное и глубокое обучение. Модели на основе ИИ применяются для прогнозирования кинетики ферментации, подкисления, роста микроорганизмов, накопления ароматических соединений, оценки качества и даже для выявления терапевтического потенциала продуктов. Наиболее часто используются Random Forest, SVM, XGBoost, искусственные нейронные сети, LSTM и гибридные архитектуры. Выбор алгоритма зависит от объёма и типа данных, а не от универсального превосходства одного метода.
Однако высокая прогнозная точность ИИ не равна биологической интерпретируемости: сложные модели часто работают как «чёрный ящик». Для решения этой проблемы развиваются подходы объяснимого искусственного интеллекта (XAI), такие как SHAP, LIME и механизмы внимания. Они показывают, какие именно переменные − гены, метаболиты, белки или технологические параметры − вносят наибольший вклад в прогноз. Это особенно важно для промышленного применения, где оператор должен понимать, почему модель рекомендует то или иное вмешательство.
Дополнительным инструментом становится цифровой двойник − виртуальная копия ферментационного процесса, которая обновляется в реальном времени и позволяет тестировать сценарии без риска для производства. В сочетании с IoT и ИИ он обеспечивает мониторинг, оптимизацию и раннее обнаружение отклонений.
Несмотря на значительный прогресс, большинство исследований пока остаются лабораторными. Перенос мульти-омикс и ИИ-подходов в реальное промышленное производство затруднён из-за высокой стоимости, вычислительных требований, нехватки стандартизированных рабочих процессов и ограниченной валидации на крупных масштабах. Тем не менее именно интеграция мульти-омикс данных, объяснимого ИИ и цифровых двойников рассматривается как путь к переходу молочной ферментации от эмпирического искусства к предсказуемой, управляемой и точной биотехнологической платформе.